RAID-Status
Lass dich warnen, wenn ein RAID-Array unter Windows oder Linux degradiert oder ausfällt, von mdadm und ZFS bis Storage Spaces.
Der Check RAID-Status überwacht RAID-Arrays und warnt, wenn ein Array degradiert oder ausgefallen ist. Ein degradiertes RAID-Array bedeutet, dass du die Redundanz verloren hast — ein weiterer Festplattenausfall könnte Datenverlust bedeuten. Der Check deckt Linux-mdadm-Software-RAID und ZFS-Pools sowie Windows Storage Spaces und Hardware-/Firmware-RAID ab; macOS wird nicht unterstützt. Standardmäßig läuft er alle 60 Minuten.
Voraussetzungen
- Du benötigst die Berechtigung Monitoring-Check-Verwaltung.
- Das Zielgerät muss einen verbundenen Agent unter Windows (Storage Spaces oder Hardware-/Firmware-RAID) oder Linux (mdadm oder ZFS) haben. Zusätzliche Software ist nicht erforderlich.
Schritte
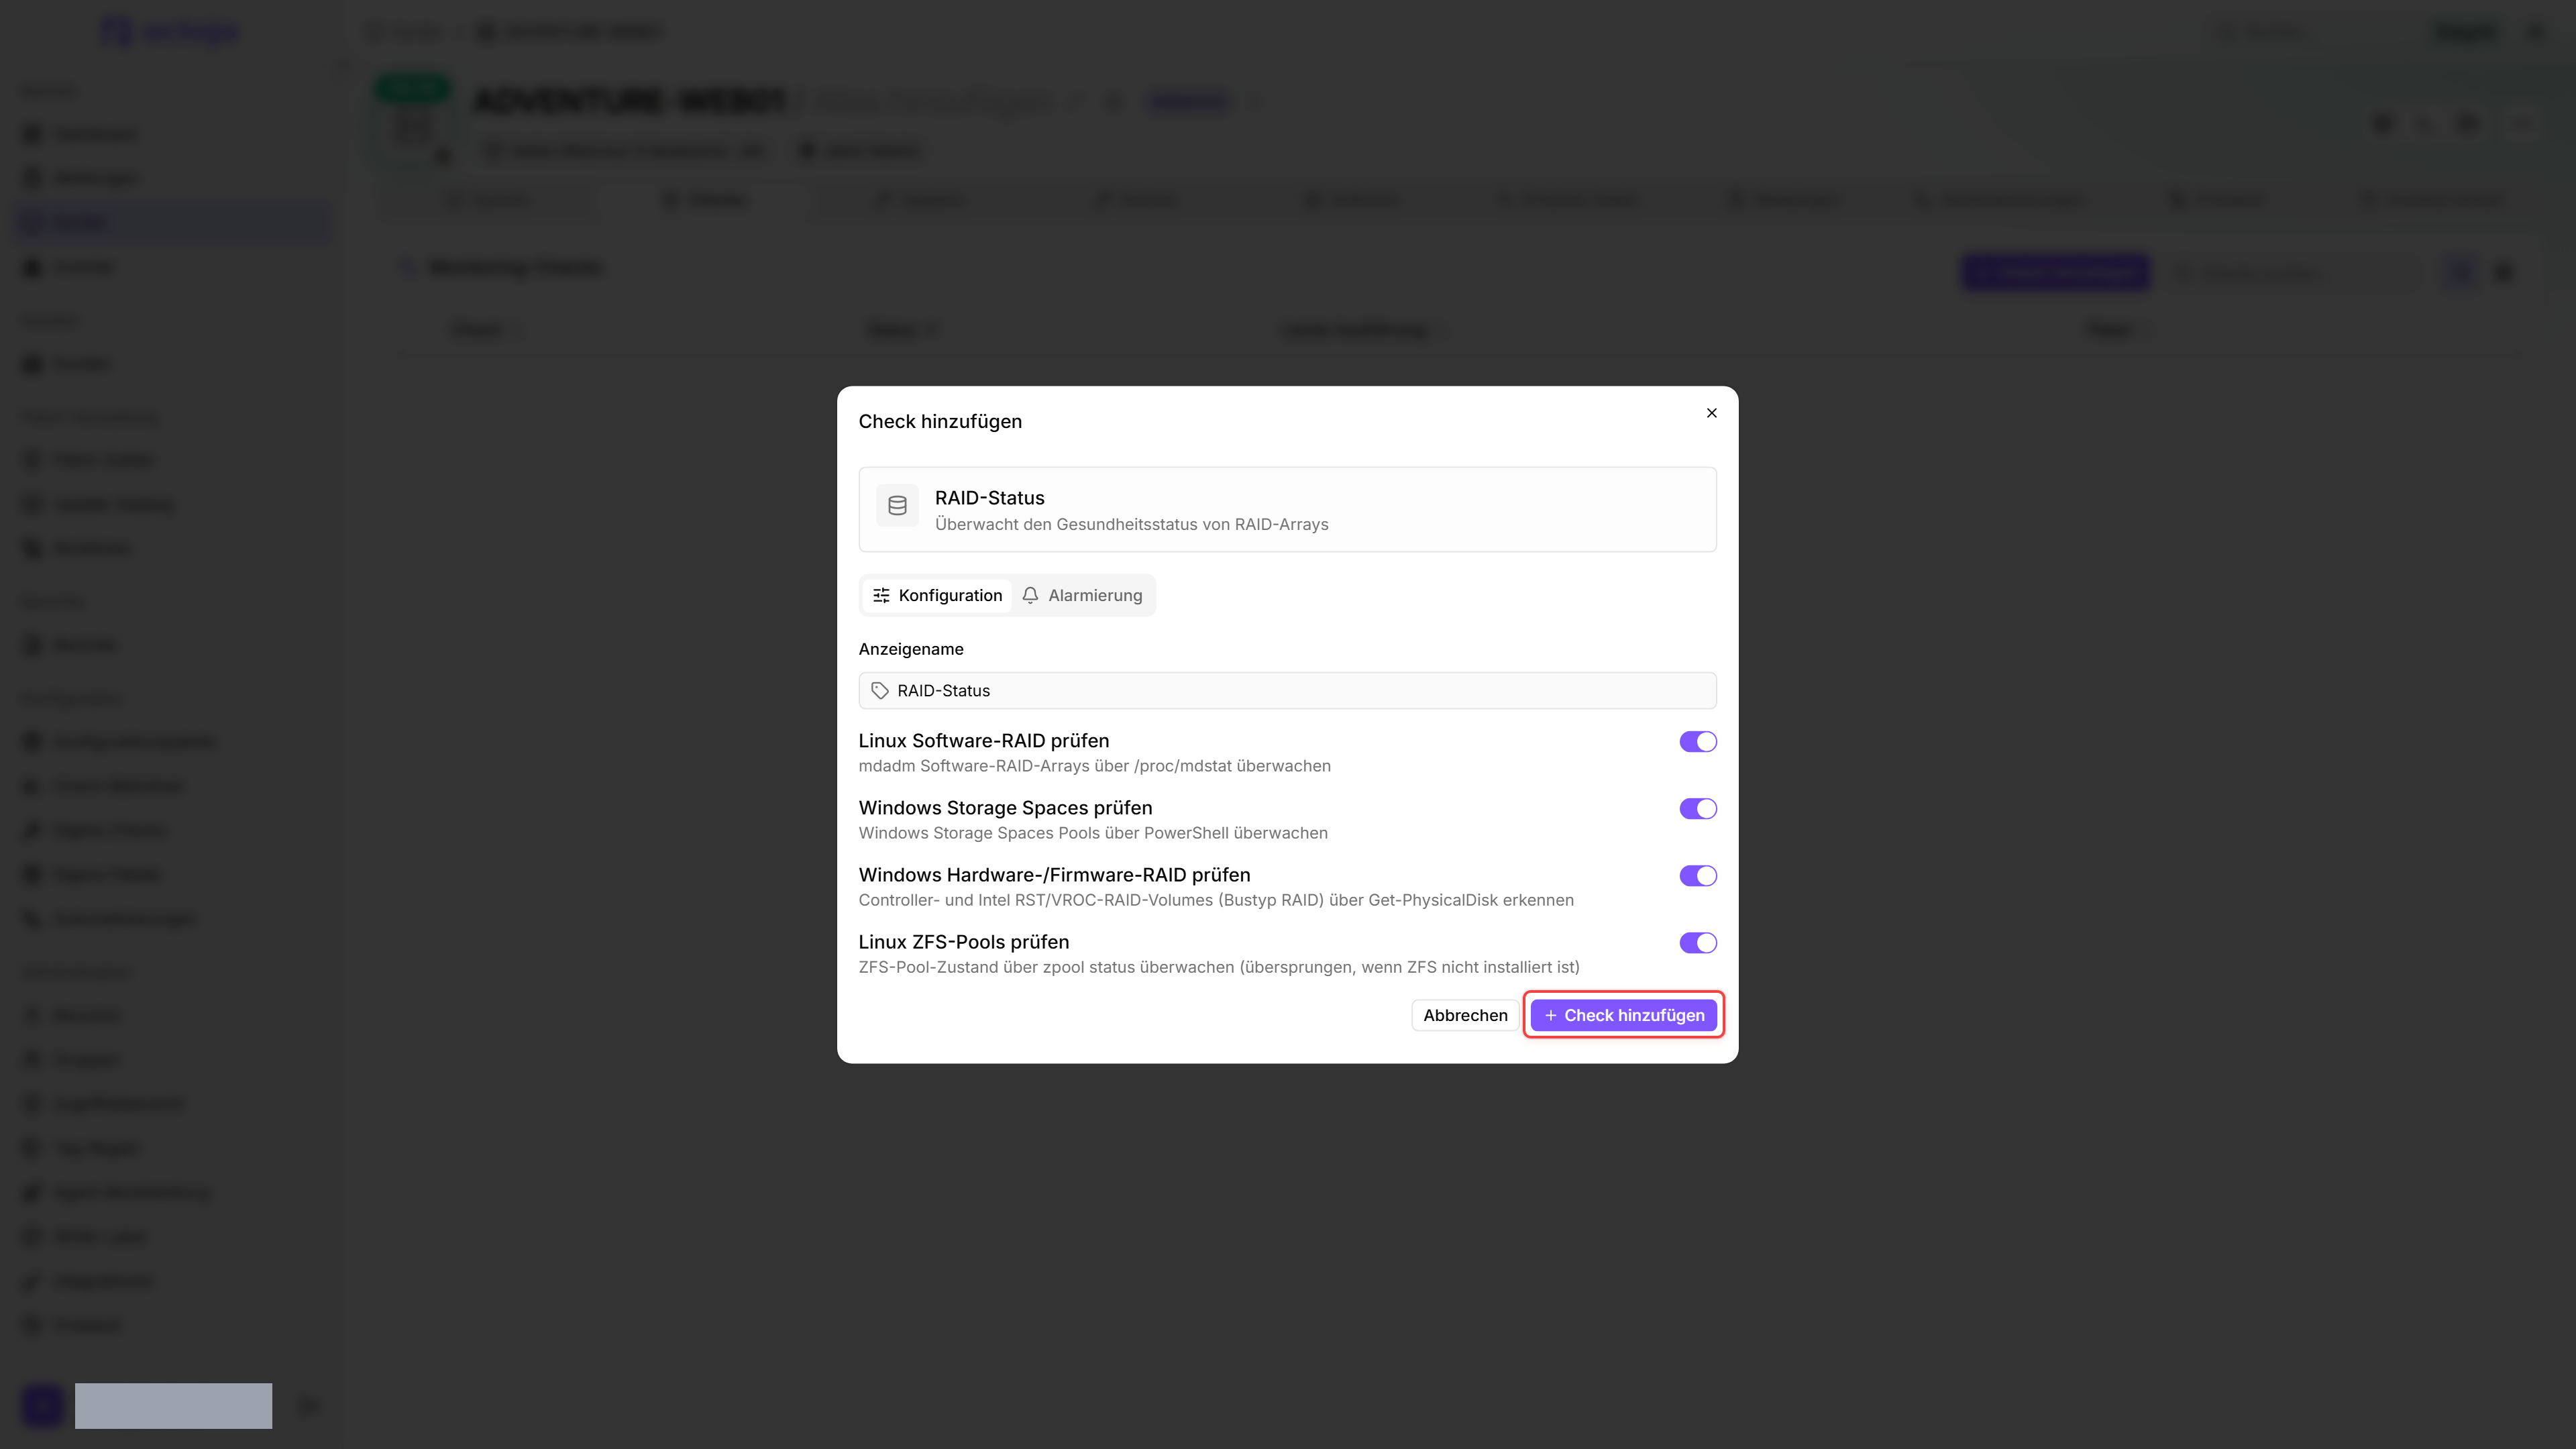
- Gehe zu Geräte und öffne das Gerät.
- Klicke auf den Tab Checks → Check hinzufügen → RAID-Status.
- Der Check erkennt automatisch verfügbare RAID-Arrays. Lege fest, welche Array-Typen überwacht werden sollen.
- Klicke auf Check hinzufügen.
Nach dem ersten Check-Intervall siehst du das Ergebnis im Tab Checks des Geräts.
Einstellungen
Ergebnisse
Ein Problem auf Mitgliedsebene eskaliert nur einen ZFS-Pool, der weiterhin ONLINE meldet. Sobald ein Pool als degradiert gilt oder ein Resilvering läuft, bestimmt sein eigener Status den Schweregrad — eine Festplatte, die während eines Resilverings erwartungsgemäß REMOVED ist, treibt einen sich erholenden Pool also nicht auf Kritisch.
Plattformen und Datenquellen
Der Check liest den RAID-Zustand vom Betriebssystem. Unter Linux liest er mdadm-Arrays über /proc/mdstat (vorhanden, wenn md-Arrays aktiv sind) und ZFS-Pools über zpool status (übersprungen, wenn ZFS nicht installiert ist). Unter Windows liest er Storage Spaces über die integrierte Storage-Management-Schnittstelle sowie Controller-/Firmware-RAID-Volumes (einschließlich Intel RST/VROC) über Get-PhysicalDisk, wobei ein RAID-Volume als einzelne Festplatte mit Bustyp RAID erscheint. Primordiale (nicht konfigurierte) Storage-Spaces-Pools werden ausgeschlossen, sodass nur von dir erstellte Pools gemeldet werden.
Grenzen bei Controller-/Firmware-RAID
Controller-/Firmware-RAID stellt nur den Gesamtzustand des Volumes bereit, den der Windows-Storage-Stack meldet. Der Ausfall einer Mitgliedsfestplatte kann hinter einem weiterhin als Healthy / OK gemeldeten Volume verborgen bleiben; dann bleibt auch das Check-Ergebnis bei OK, obwohl das RAID-Verwaltungswerkzeug des Herstellers das Array als degradiert meldet. Eine Degradation solcher Arrays ist daher nicht zuverlässig erkennbar. Überwache solche Arrays zusätzlich mit dem Verwaltungswerkzeug des Controller-Herstellers.
Für Controller-/Firmware-RAID-Volumes wird keine Anzahl der Mitgliedsfestplatten angezeigt, weil die einzelnen Festplatten nicht über das RAID-Volume bereitgestellt werden. Der SMART Festplattengesundheit-Check kann den Zustand einzelner Festplatten nur ergänzen, wenn Windows diese Festplatten bereitstellt. Hardware-Controller und einige Intel-RST-Konfigurationen verbergen diese Festplatten, sodass SMART keine universelle Ausweichlösung ist.
Erfasste Metriken
- Array-Name (pro Array)
- Array-Status (
healthy,degraded,unhealthy,unknownoderrebuilding— mit dem Neuaufbau-Prozentsatz, während ein Array neu synchronisiert) - Array-Level (z. B.
raid1,raid5,Storage Spaces,ZFS,RAIDfür Windows-Hardware-/Controller-Volumes) - Anzahl aktiver und gesamter Festplatten pro Array
- Mitgliedsfestplatten pro Array — Name und Status jedes Mitglieds eines mdadm-Arrays (
online,faulted,rebuildingoderavailfür eine Ersatzfestplatte), eines ZFS-Pools (der kleingeschriebene Gerätestatus auszpool status, etwaonline,degraded,faulted,offlineoderremoved) und eines Storage-Spaces-Pools (healthy,degraded,unhealthy,rebuildingoderunknown); ZFS-Pools melden ihre Mitglieder anstelle einer Anzahl aktiver/gesamter Festplatten - Anzahl der Lese-, Schreib- und Prüfsummenfehler pro Mitgliedsfestplatte (nur ZFS)
- Ergebnis-Status pro Array
Mitgliedsfestplatten erscheinen im Detailbereich des Checks unterhalb ihres Arrays. ZFS-Mitglieder sind eingerückt und bilden so den vdev-Baum des Pools ab: Die Festplatten einer mirror- oder raidz-Gruppe stehen unter dieser Gruppe, und Abschnittsüberschriften wie logs, cache und spares stehen über ihren Geräten; die Lese-, Schreib- und Prüfsummenzähler eines Mitglieds werden daneben angezeigt, sobald einer davon ungleich null ist, und jeder Hinweis, den zpool status zu einem Mitglied ausgibt — (resilvering) oder currently in use für eine eingesprungene Ersatzfestplatte — erscheint neben dessen Namen. Eine Festplatte, die mdadm vollständig entfernt hat, taucht in /proc/mdstat nicht mehr auf und fällt damit aus der Liste — erst die Anzahl aktiver/gesamter Festplatten macht die entstandene Lücke sichtbar.
War dies hilfreich?
Brauchen Sie noch Hilfe? Team fragen